

热门文章
dma、neon、cpu这3种拷贝方式,怎么选
时间:2026-08-20
编辑者:创龙科技
大家好,我是发际线守护者,一名坚守「一般情况不加班」原则的软件工程师。搞工控异构多核的兄弟们,核间通信传输带宽总是低,是不是很头疼?
在此推荐基于共享内存的核间通信机制,数据直接映射共享,配合rpmsg机制,具有“零拷贝”“高带宽”的显著优势,解决核间通信传输带宽低的难题!
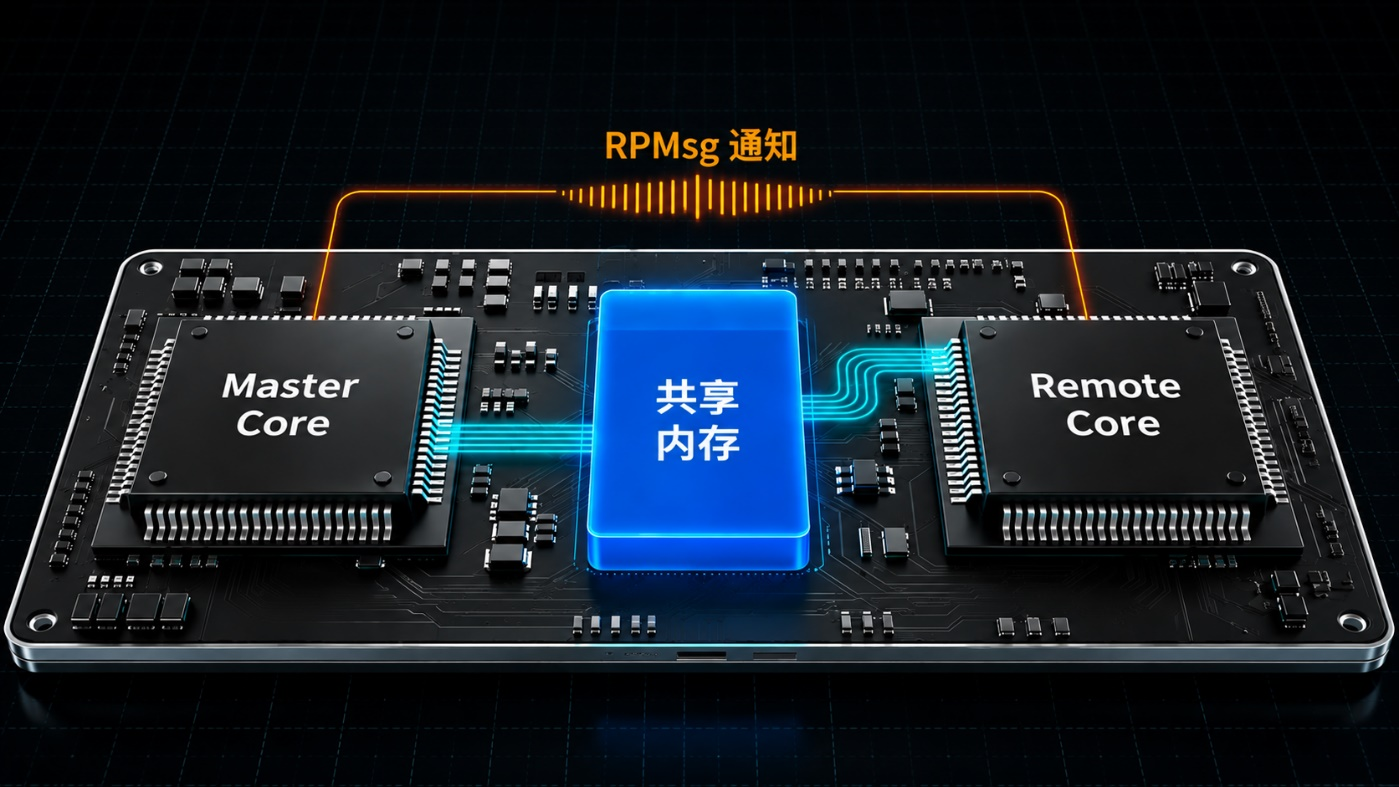
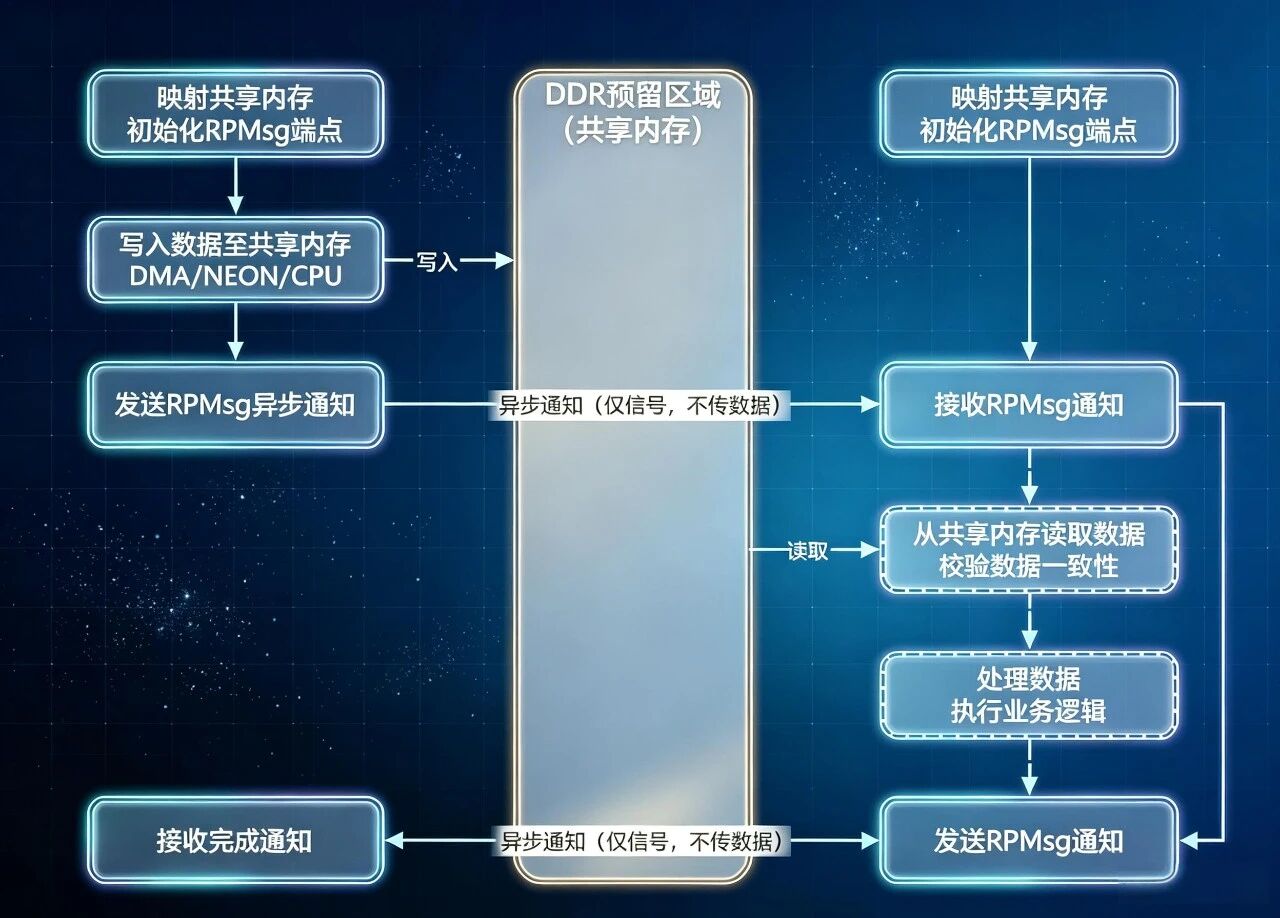
异构多核如何实现高效传输数据?核心思想是将数据与控制分离,即共享内存 rpmsg机制:
(1)数据层:主核(master core)与从核(remote core)均可直接读写ddr中预留的共享内存区域,零拷贝完成大数据传输。
(2)控制层:rpmsg仅作为异步通知信号,告知对端“数据已就绪”,不承载数据本身。
dma、neon、cpu这3种拷贝方式各有优劣,实际开发中无需盲目追求高带宽,应根据使用场景、资源占用情况进行选择:
dma:传输稳定,cpu零负担
依靠专用硬件控制器搬运数据,不占用cpu资源,适合大数据量、高带宽需求的应用场景。
neon:无dma时的备选,cpu同样零负担
一般处理器的dma控制器资源有限,在没有多余dma控制器时,neon方式是另一个不错的选择,它是cpu的辅助核,同样不占用cpu资源,利用cpu的单指令多数据流技术,实现并行数据搬运。
cpu:实现简单,但需消耗cpu资源
无需额外硬件资源,适用于小数据量、性能要求不高的简单应用,缺点是搬运过程会持续占用cpu资源,不适合复杂应用。
基于创龙科技全志t153工业评估板,实测dma、neon、cpu三种内存读写方式,在共享内存核间通信机制下的传输性能表现。
执行如下命令,测试2kbyte、4kbyte…8mbyte等不同数据量的读写带宽。
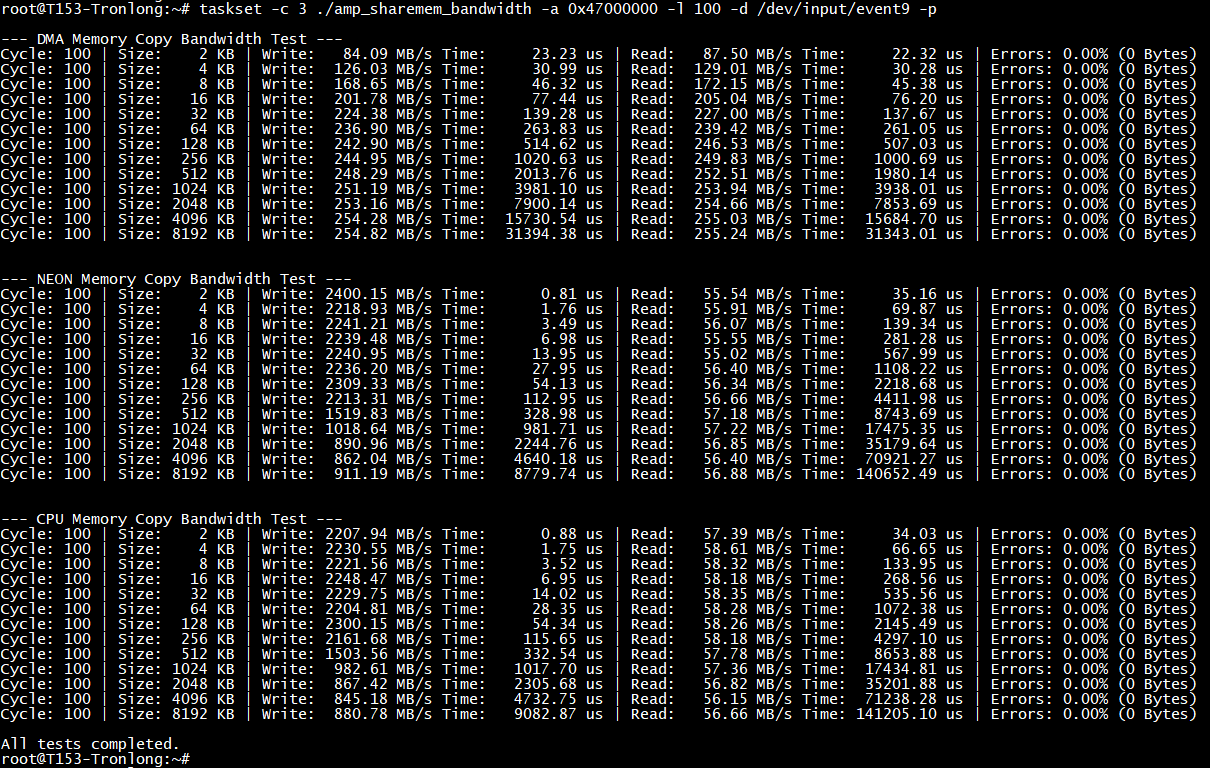
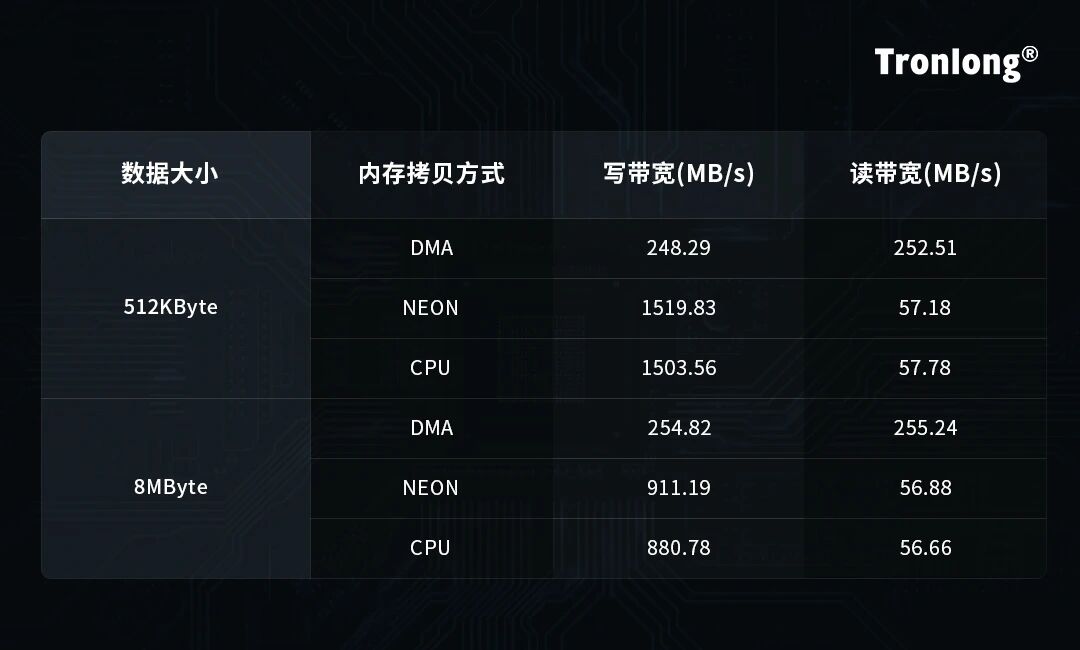
以512kbyte、8mbyte传输数据量为例,三种内存拷贝方式的读写带宽如下:
经过本次测试可知:
(1)dma方式读写性能均衡、带宽稳定,大小块传输表现都很平稳。
(2)neon、cpu方式在写带宽上表现出色,但读带宽偏低。这是由于写操作可借助写合并机制提升写带宽,能将多个写操作合并为单次、大数据传输,减少总线事务,因此写带宽表现亮眼。而读操作无法合并,每次读取需等待内存响应,导致读带宽显著偏低。
(3)随着数据量增大,neon与cpu方式的写带宽明显下滑,而dma方式性能影响较小。
通过共享内存 rpmsg机制,解决了核间通信时传输带宽低的问题,让数据直接在共享内存中零拷贝传输,传输带宽得到质的飞跃!
 客服

提交成功